Introducción a IBM® Tivoli® Netcool ®
IBM® Tivoli® Netcool ® forma parte del «Tivoli Management Framework (TMF)», y ambos pertenecen a la miríada de productos de la más que centenaria empresa denominada «International Bussines Machines» o simplemente IBM®, como la conocemos hoy día. Recordemos que esta empresa fue la encargada de automatizar los censos poblacionales en los Estados Unidos de América en el siglo XIX (para ese entonces su nombre era «Tabulating Recording Company»1 y aún no se había aventurado fuera de su propio país) y fue la responsable indirecta de masificar la computación personal («Personal Computing» o PC) en el siglo XX (papel protagonista que tomó, aprovechando las oportunidades, la empresa Microsoft para afianzarse por muchos años en el mercado). No es de extrañarnos, entonces, que tengan una solución para todo tipo de empresa a lo largo y ancho de este planeta: son muy organizados, esquematizados y muy bien documentados. Tanto es así en este último punto, lo que para sus empleados es natural (informes de cientos e incluso miles de páginas) para nosotros nos produzca un mar de información aparentemente inconexa.
La guía de implementación «IBM® Netcool ® Operations Insight Version 1.4» ocupa 292 páginas en formato PDF, está escrito por cinco autores y pesa 12 megabytes, estamos hablando del manual, ¡la guía rápida!2 Tan grande es esta corporación que la división llamada RedBooks® es la encargada de categorizar, publicar en línea (o en papel, si lo necesitamos) de manera pública y expedita todo lo relacionado con la documentación de sus muy diversos productos. Esta división y especialización del trabajo la mencionamos de manera obligada porque más adelante veremos que el software está fuertemente orientado al trabajo en equipo y colaboración entre departamentos tanto de la empresa cliente como la propia IBM®.
En esta entrada simplificaremos al máximo pero no será pequeño el texto, como tampoco lo es el Gigante Azul («Big Blue»)1, nombre con el cual también es conocida esta empresa por todo el planeta.
IBM® Tivoli® Netcool ®
Primero deberemos aclarar que «IBM® Tivoli® Netcool ®» como la presentamos, pues no, no es su nombre exacto y completo. Para mayor precisión, el concepto que abstrae en una sola piedra angular toda esta tecnología que IBM® presenta como una solución completa es «IBM Netcool Operations Insight«®. A lo largo del tema nosotros podremos simplemente denominarla y referirnos a ella, ya sea como un todo o uno o más de sus componentes, como Netcool ® tal como se le ha abreviado en sus más de 25 años de existencia en el mercado corporativo.
«IBM Netcool Operations Insight»® integra la gestión de infraestructuras y operaciones en una sola estructura coherente entre aplicaciones de negocio, servidores virtualizados, protocolos y dispositivos de red, protocolos de internet y dispositivos de seguridad y almacenamiento.
La solución incluye los componentes siguientes:
- IBM® Tivoli® Netcool ®/OMNIbus.
- IBM® Tivoli® Netcool ®/Impact.
- IBM® SmartCloud Analytics®.
- IBM® Tivoli® Netcool ®/OMNIbus Insight Pack for IBM® SmartCloud Analytics®.
- IBM® Tivoli® Netcool ®/OMNIbus Message Bus Gateway.
- IBM® Tivoli® Network Manager IP Edition ®.
- IBM® Tivoli® Netcool ® Configuration Manager.
- Jazz for Service Management®.
Cada uno de estos componentes se instala por separado3, cada uno tiene su manual de procedimiento e implementación pero una vez que ya están todos instalados ¿podemos echar manos a la obra y comenzar así a monitorizar nuestra red? Pues no, aún falta «Netcool ® Network Management» : esta solución única combina «IBM® Tivoli® Netcool / OMNIbus»®, «IBM Tivoli Network Manager»® e «IBM Tivoli Netcool Configuration Manager»® (se debe configurar las comunicaciones entre productos para que pueda funcionar)4.
«Netcool Network Management»®
«Netcool Network Management»® es un conjunto integrado de herramientas de gestión de red, que proporcionan descubrimiento de red, supervisión, gestión de sucesos y configuración. Permite una visión centralizada que incluye creación de informes, permite supervisar la red tanto en su desempeño, despliegue y cambios, amén de la gestión y manejo de errores.
Está pensada para dar servicio a millones de eventos por día incluyendo redes físicas y virtuales, mantiene y maneja las operaciones de los distintos componentes que instalamos y centraliza los reportes. Pero quizás la tarea más significativa, dicho en propias palabras de la empresa: «Muestra líneas base de índice de sucesos, previsiones y tendencias que permiten identificar problemas subyacentes y le ayudan a afrontar los problemas de forma proactiva.»
Esto último lo presentan y lo integran como «Inteligencia Artificial» y «Computación en la nube», un enfoque no solo correctivo sino que a la vez es manejado de manera preventiva.
Modo de funcionamiento.
A pesar de toda la grandilocuencia que presenta el software, en última instancia, observamos que Netcool ® , luego de toda su laboriosa instalación, presenta los mismos elementos comunes que la mayoría de programas dedicado a la monitorización de ordenadores: lo destacable es la magnitud que asume el programa, que de hecho da por cierto y real que la empresa que lo contrata es de gran nivel y a escala planetaria.
Por ejemplo, para agregar un elemento controlador personalizado para monitorear un servidor GNU/Linux5, utilizaremos el «IBM Tivoli Netcool Configuration Manager»®, opción «Tools» y luego «New driver» tras lo cual se abre un cuadro de diálogo guiado al cual le indicamos que deseamos utilizar una plantilla de IBM basado en Telnet o SSH. A continuación llenamos de detalles la ficha del nuevo controlador (sistema operativo, versión, etc.) siempre separando por medio de comas si va a tener el propósito de usufructar diferentes versiones, avanzamos a la sección de guiones de dispositivo («IT MCM communications handle») y bien podemos agregar nuestro propio código, que lo permite, o utilizamos el de algún dispositivo que tenga similar conexión, como por ejemplo un enrutador. Esto último pareciera que no se debe hacer ya que no se corresponde con la realidad pero recordemos que estamos especificando la manera de conectar al dispositivo y no estamos describiendo al dispositivo en sí mismo, que eso lo hicimos claramente al principio.
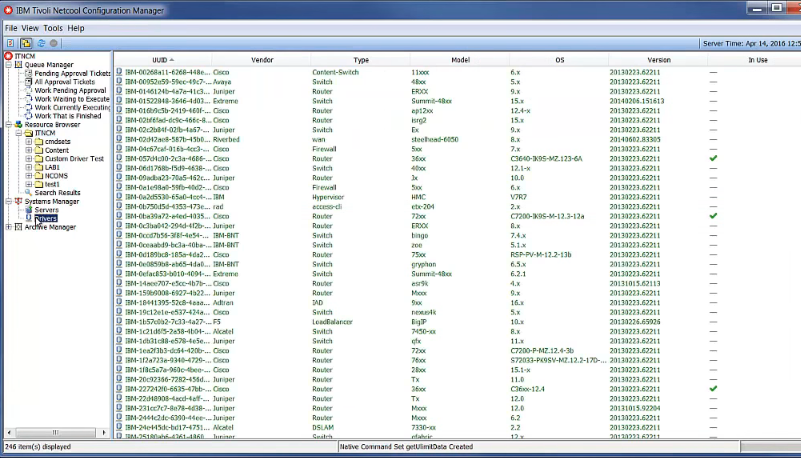
Lo siguiente que debemos hacer es remover el código correspondiente a la conexión a un enrutador pero que NO es compatible con el servidor GNU/Linux que necesitamos monitorear. Esto es posible porque utilizamos una plantilla la cual es copiada automáticamente, y ya forma parte, del controlador que estamos creando. Finalmente agregamos los comandos de ejemplo que deseamos que realizen el trabajo para luego recolectar la información:
$ cat /etc/redhat-release
$ cat /etc/hosts
$ netstat -nr
La siguiente sección informará cómo se conectará al servidor GNU/Linux, si envía o recibe y envía información, así como una multitud de detalles que deberemos adecuar (este asistente es muy general para permitir el conectar una cantidad masiva y distinta de dispositivos y aparatos, debemos cuidar muy bien que seleccionamos; todo está muy bien documentado).
Al finalizar de crear el elemento controlador personalizado debemos proceder a importarlo al esquema de trabajo: la dirección IP del dispositivo a monitorear, credenciales, horario, etc. De una vez podremos ejecutarlo y ver inmediatamente el resultado en consola, analizarlo y si es necesario corregirlo (el guion) para dejarlo establecido y monitoreando.
Como podemos ver no es muy diferente a la creación de lo que en PandoraFMS llamamos plugin remoto y su creación y registro 6, con la diferencia de que con Netcool ® el proceso es mucho más robusto, con una cantidad de pasos adicionales y multitud de detalles. Esto es así porque debemos recordar que IBM® tiene experiencia como fabricante de hardware y toda esa experiencia acumulada durante años y años se ve reflejada (y utilizada en provecho) en cada aspecto de su software.
Almacenamiento de resultados y datos recolectados.
Una vez que tenemos los agentes recolectores de datos pues necesitamos almacenarlos para su posterior análisis. A tal efecto está destinado a trabajar el «Netcool OMNIbus»® para llevar el «Database Gateways»7 que consiste, esencialmente y sin entrar en mayores detalles, en una base de datos para reportes y una para auditoria. La diferencia entre ambas es que para la auditoria cada adición, modificación o eliminación de un componente genera un registro mientras que en la de reportes son acciones realizadas para un componente.
Para reportes se puede escoger entre las siguientes tecnologías: Oracle®, Sybase®, MSSQL®, DB2®. Por otra parte en auditoría también podemos usar dichas bases de datos y, además, Informix® y MySQL®.
Se incluye conectividad adicional mediante tres componentes8:
- Oracle gateway : Oracle libraries.
- ODBC gateway : DataDirect ODBC drivers.
- JDBC gateway : vendor-provided JDBC drivers.
Esta última, JDBC (Java Database Connectivity) es la recomendada por ser históricamente utilizada y es la puerta de entrada para cualquier software de terceros (área de auditoría) el obtener los datos necesarios.
Forma de trabajo de Netcool ®.
Como recién vimos, es larguísimo el describir esta suite de monitoreo informático, porque fue creada de tal manera que se integre de manera necesaria con los demás productos de la compañía. De seguir así no terminaríamos este artículo y muchísimo menos podríamos hacer una comparativa con PandoraFMS. Por ello, ya que explicamos un panorama general de Netcool ® (implementación, configuración, agentes y almacenamiento de información) sin incluir el software de predicción de problemas, comunicación entre responsables de soporte, etcétera; procedemos a razonar una visión general que incluso se puede extender a otros software de monitorización para así realizar comparativas9.
Por parte de las máquinas.
- De manera masiva los agentes recogen todos los eventos e incidencias y sin excepción son almacenadas en poderosas bases de datos.
- Por medio de reglas preestablecidas se procede a filtrar el material que cumpla con los requisitos, cada cliente tiene sus propias necesidades y/o prioridades, las que se necesitan se pasan al siguinte nivel.
Por parte de nosotros los humanos.
- Las máquinas hicieron su trabajo, ahora toca a los humanos el evaluar alertas, identificar fallas y crear boletos para su resolución: estamos en la etapa de la detección. En este punto es bueno descartar los falsos positivos, no sin antes hacerle su debido registro, que puede ser utlizado a futuro para correlacionar eventos, lo que nos lleva al siguiente punto.
- Los boletos que se abrieron en la etapa anterior se asignan de acuerdo a los conocimientos sobre el tema: estamos en la etapa de reacción.
- Ya en manos adecuadas y familiarizadas con la falla o fallas en cuestión se procede a la revisión de pruebas y evidencias, estamos en la etapa de diagnóstico. Es acá donde se planifica el siguiente punto, del cual probablemente se encargará otro equipo de trabajo.
- En la fase de restauración o reparación se aplican las medidas diseñadas dando así por finalizado el incidente a efectos de operatividad pero a nivel de predicción y evaluación a futuro se pasa a otros departamentos y esto excede ya las tareas de monitorización de servidores y redes y cae más bien en el campo de control y previsión de pérdidas.
El enfoque de PandoraFMS.
Es una lección aprendida que hay tareas adecuadas para las máquinas y tareas adecuada para los humanos10. Es por ello que en lo que se refiere a analizar millones de eventos y correlacionarlos pues las máquinas son las más adecuadas para recogerlas (primer paso que explicamos en el Modo de funcionamiento) y luego detectar las anomalías, incluso si están repetidas: esto es cuestión de segundos, lo que nos llevaría horas a nosotros el manejarlos. En lo que somos buenos los humanos es en analizar decenas de problemas y determinar sus causas de orígen, siempre teniendo a la mano los datos bien presentados para basar las decisiones. Minutos después se planificará la solución y será devuelta a las máquinas, quienes la aplicarán en segundos (y en unos cuantos segundos más aprenderán del fallo).
En este aspecto Pandora FMS rompe con lo establecido en monitorización11: evitamos la monitorización compleja y fragmentada fruto de múltiples productos con interfaces de usuario diferentes y separadas, funcionando sobre bases de código separadas y hasta almacenamientos aparte unas de otras; todo esto únicamente da como resultado una implementación sumamente complicada y peor aún, dificulta el mantenimiento una vez se haya logrado implementar. Se traduce que una gran complejidad tiene un coste muy elevado y un elevado tiempo de evaluación. Es por ello que a la hora de adaptarse a las necesidades del cliente PandoraFMS brilla por su estructura de un solo cuerpo, permite implementar los cambios sin retrasos en extensas reuniones de quipos de trabajo por departamento para evitar que los cambios en un módulo no perjudiquen y mantengan la compatibilidad con los otros componentes. Una vez modificado y actualizado el programa, PandoraFMS entrega a todos sus clientes una actualización inmediata gracias a nuestrao nuevo sistema de versionado, los parches y mejoras –incrementales– se irán aplicando de forma progresiva y secuencial desde la consola, sin necesidad de procesos de migración o actualización12. Una gran complejidad reduce la eficiencia.
Pros y contras de ambos productos.
Colocar en la balanza las ventajas y desventajas ayudará a discernir cual camino de monitorización será el mejor indicado para cada cliente.
Netcool ®
Pros
Tiene como ventaja una larga experiencia de procesos, los han visto todos y los tienen almacenados, categorizados y muy bien documentados. Será bastante difícil que una empresa cualquiera presente un reto nuevo a esta antiquísima y bien cultivada tecnología.
Contra
Precisamente el análisis al extremo de departamentalizar y establecer divisones especializadas conduce un trabajo adicional de comunicación y registro entre ellos, lo cual reduce la eficiencia. Se corre el riesgo, incluso, de aislamiento de áreas de monitorización. Otro punto es la subestimación de los requerimientos del cliente: se supone que ya está todo categorizado y normalizado y se trata de venderle del catálogo de productos los que se acerquen a la solución, aquí no hay productos a la medida.
PandoraFMS
Pro
Se maneja todo conjuntamente lo cual se traduce en rapidez, visión de un solo golpe de los eventos para su posterior solución y corrección. Acá se reduce grandemente el tiempo inactivo de la empresa, que es de gran coste económico. Dejamos que las máquinas hagan el trabajo que mejor saben hacer para que los humanos tengan la mínima intervención pero que a la hora de tomar las decisiones las hagan sobre datos sólidos, confiables y bien presentados. Teniendo mucho cuidado en no caer en gran complejidad, de hecho es opcional, se desarrolló Integria IMS13: una gestión correcta del flujo de trabajo de los equipos que responden a las incidencias presentadas.
Contra
Hay un refrán que dice «no hay mal que por bien no venga»: es como las administraciones de tráfico aéreo, cuando sucede una catástrofe no solamente se resuelve el caso sino que se aprovecha de implementar medidas a futuro para evitar su repetetición, incluso si suceden de manera análoga. Este punto se subsana porque en PandoraFMS la flexibilidad es nuestro compromiso y podremos escuchar para mejorar e incluso desarrollar elementos nuevos que suplan las carencias a futuro.
Marcas registradas.
- IBM, the IBM logo, e ibm.com son marcas o marcas registradas de «International Business Machines Corporation», registrada en muchas jurisdicciones a nivel mundial. Otros productos y nombres de sevicios pueden pertenecer a IBM u otras compañías. Una lista actual de marcas registradas de IBM está disponible en internet en la página web titulada “Copyright and trademark information” ubicada en http://www.ibm.com/legal/copytrade.shtml
- Los siguientes términos son marcas registradas de «International Business Machines Corporation», y también pueden ser marcas registras no solo en Estados Unidos sino en otros países:
- DB2®
- IBM®
- JazzTM
- Netcool ®
- Passport Advantage®
- Redbooks®
- Redbooks (logo)
- Tivoli®
- WebSphere®
- El logotipo aquí utilizado está definido por formas geométricas que no reúnen los requisitos para llegar al umbral de originalidad y por tanto reúne el requisito de dominio público: tales conceptos y ficheros pueden ser leídos en el siguiente enlace de Wikipedia: https://commons.wikimedia.org/wiki/File:IBM_logo.svg
Imágenes empleadas.
Aparte del logotipo de IBM® señalado debidamrente en la sección anterior, utilizamos las siguientes imágenes con sus orígenes:
- «Creating custom standard drivers in IBM Tivoli Netcool Configuration Manager» en Wikimedia Commons.
Fuentes consultadas
- «IBM: El gigante azul cumplió 100 años«.
- «IBM Netcool Operations Insight Version 1.4 Deployment Guide» por Shaker Al-Muaber, Fernando de Andrade Cavalcanti, Vasfi Gucer, Mario Schuerewegen y Steven Shuman.
- «Netcool Network Management«.
- «Netcool Operations Insight, version 1.2, Quick Start Guide» en formato PDF.
- «Creating custom standard drivers in IBM Tivoli Netcool Configuration Manager» vídeo en Youtube.
- «Creacion plugin remoto con Pandora FMS» por Carla Andrés.
- «Historical Database Gateways – An Overview» por Toni Idowu.
- «Support’s Guide to the JDBC Gateway«.
- «An Alternative to IBM Tivoli Netcool: Or How to Migrate from Your Legacy IT System» por Mike Silvey.
- «Buenas Prácticas de monitoreo» por Javier.
- «Pandora FMS rompe con lo establecido en monitorización» por Carla Andrés.
- «Novedades en Pandora FMS 7.0 Next Generation» por Carla Andrés.
- «Integración tickets Pandora FMS – Integria IMS» por Carla Andrés.