Grandes Datos tenemos todos y todas en nuestros ordenadores y os lo demostraremos con Log Parser y las nuevas herramientas: Beats, LogStash, ElasticSearch y Kibana.
Introducción
Grandes Datos (sí, en mayúsculas) por aquí, Grandes Datos por allá; lo escuchamos en la radio del coche cuando vamos al trabajo, en el kiosco de periódicos en la esquina o lo leemos en nuestro móvil cuando vamos en el subterráneo rumbo a casa. Cuando escuchamos esas palabras Grandes Datos de inmediato pensamos en empresas con Google®, DuckDuckGo®, Microsoft® o Amazon® y asumimos que nosotros somos una leve pluma en el viento de las transnacionales que controlan nuestras vidas y que anhelan, algún día, controlar nuestro pensamiento. Si bien los Grandes Datos describen, por ejemplo, las rutinas (compras, transporte, etc.) de los habitantes de una ciudad o países enteros, su capacidad no son las cifras macro en sí, sino que podemos con una lupa acercarnos a buscar alguna categoría. No negamos que estén al nivel de hallarnos por nuestro DNI pero a menos que seáis policía o investigador privado hay leyes que nos protegen de ello (por ahora).
No tenemos que ir muy lejos para tropezarnos con los Grandes Datos, de hecho nuestros ordenadores a medida que ha transcurrido el tiempo se han vuelto muy poderosas, con dispositivos de almacenamientos de varios terabytes, y eso es mucho espacio, un terabyte es equivalente a 1 000 000 000 000 de bytes ¡un billón nuestro, un trillón para los anglosajones! Claro, ya habréis pillado que ese es el espacio que tenemos, no el que realmente usamos pero con las capacidades multimedia ahora nuestros vídeos y fotografías copan rápidamente el espacio y sin embargo no estaríamos hablando de Grandes Datos: nos atrevemos a clasificar eso como «Datos Cuánticos» porque solo una nueva generación de computadoras podrían manejar tal volumen de datos (hablamos de nuestros vídeos y fotografías personales, su análisis y clasificación).
Pongamos los pies en la Tierra, vamos a por ello, hoy os hablamos de un tema que para Pandora FMS no era un problema en sí sino más bien una preocupación. Os narramos que una cosa era seleccionar datos y otra filtrar datos (Grandes Datos) -filtrar en el sentido de pasar por un tamiz- y desde la versión NG 712, y gracias a la increíble flexibilidad de Pandora FMS, echamos mano de dos grandes herramientas: LogStash y ElasticSearch. No os coparemos con detalles técnicos porque el equipo de Pandora FMS ya ha trabajado en vuestro favor con una completa y estupenda guía de despliegue pero sí que haremos un muy breve resumen (todos los enlaces incluidos os permitirán ahondar más en cada punto).
Grandes Datos, Pandora FMS, LogStash y ElasticSearch
Esquemáticamente, esta es la propuesta de Pandora FMS para manejar los Grandes Datos obtenidos, cómo no, de los archivos de registros. Si bien una consola puede residir en un servidor Pandora FMS recomendamos que LogStash, ElasticSearch tengan sus propios servidores y MySQL sus racimos para respaldos redundantes. Para nosotros practicar bien podemos utilizar máquinas virtuales, con propósitos didácticos. A partir de la versión NG 717 implementamos el SyslogServer el cual permite unificar los registros de diferentes orígenes y luego veremos el porqué esto es necesario. El SyslogServer no está representado en la imagen (la cual llamaremos figura N° 1 en el resto del artículo).
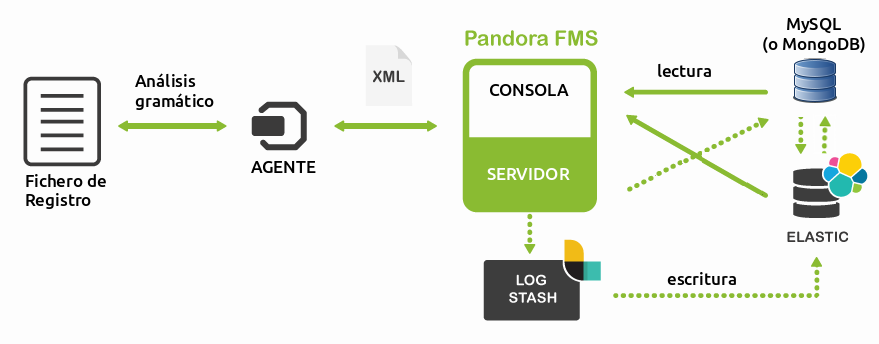
De este gráfico partiremos para practicar y realizar unas pruebas de concepto para nuestros datos y si necesitan alguna ayuda para implementar los servidores necesarios para Pandora FMS no duden ni por un momento en ponerse en contacto. Si vamos de izquierda a derecha notamos nuestra materia prima los archivos de registro o «logs» pero, ¿qué son en realidad?
Nuestros Grandes datos: archivos de registro o «logs»
La palabra inglesa «log» en realidad significa rolo o tronco y la idea de enlazarlo conceptualmente como sinónimo de registro tal vez provenga del antiquísimo invento de los papiros enrollados para guardar datos (de hecho la religión judía aún guarda el Talmud, por tradición, de esa manera).
Nosotros nos referimos a los archivos de registro que bien os explicamos en un artículo anterior de uno de nuestros colegas donde jocosamente llamamos «la hermanastra fea» de la monitorización. En esa buena entrada de nuestro blog especificamos que para el sistema operativo -privativo, por demás- Microsoft Windows® aparte de los comunes archivos de texto plano (simples ficheros con la extensión «.log») también tenemos los poderosos ficheros de sistema «.evt» y «.evtx«,¡vamos a ver qué son!
Log Stach y los Grandes Datos de nuestros ordenadores personales
Admitamos que en nuestros hogares tenemos aunque sea un ordenador con este sistema operativo Microsoft Windows®, o en el caso nuestro varias máquinas virtuales con diferentes versiones del mismo. Aunque lo más probable sea que sean las computadoras de nuestro trabajo u oficina estén siendo monitorizadas (y si es con Pandora FMS, mejor) más las de nuestros hogares están desprovistas de un agente de monitorización. Puede suceder que necesitemos saber si han intentado acceder a nuestras máquinas, cuándo se ha desactivado el muro de fuego, desde cuáles direcciones IP se han conectado de manera remota, eventos del antivirus y muchas otras causas y razones. Beats (Filebeat) es un agente multipropósito que podrá enviar los datos directos a Log Stash, como es muy complejo simplemente os dejamos el enlace.
Como no sabemos con exactitud qué vamos a necesitar, pues simplemente tomamos todos los logs y les damos un muy buen uso, como por ejemplo en este horno que quema leña para nuestra pizza.
Nuestro «horno» será Log Stash y se alimentará de nuestros logs pero primero necesitamos de un hacha, una herramienta para trocearlos y dividirlos y clasificarlos para la faena. Para ello vamos a echar mano de Log Parser una buena herramienta para extraer los Grandes Datos.
Log Parser
Como dijimos los archivos de registro en Microsoft Windows® («.evt» en Windows 2000®, Windows XP® y Windows 2003® y en formato XML «.evtx» para Windows Vista®, Windows 7®, Windows 8® y Windows 10®) están almacenados en la carpeta de sistema correspondiente ¿cómo podremos leer este formato especial? Si bien podemos leerlos y revisarlos con la aplicación «eventvwr.msc» de manera gráfica o por línea de comandos con «wevtutil.exe» no podremos seleccionar y exportar de manera masiva y automatizada. Recalcamos que estamos trabajando con Grandes Datos, no los podemos subestimar, y con las herramientas que trae incorporada atenderemos trabajos de manera muy puntual.
Una manera de leer dichos registros (los cuales están clasificados en eventos de Sistema, Seguridad y Aplicaciones, los registros del sistema operativo, no los que llevan el resto de las aplicaciones instaladas) es acceder a ellos por medio de una aplicación en lenguaje C++ que desarrollemos. Por ejemplo, deberemos definir el encabezado del registro en una variable especial donde la alojaremos al leerla:
typedef struct _EVENTLOGHEADER {
  ULONG HeaderSize;
  ULONG Signature;
  ULONG MajorVersion;
  ULONG MinorVersion;
  ULONG StartOffset;
  ULONG EndOffset;
  ULONG CurrentRecordNumber;
  ULONG OldestRecordNumber;
  ULONG MaxSize;
  ULONG Flags;
  ULONG Retention;
  ULONG EndHeaderSize;
} EVENTLOGHEADER, *PEVENTLOGHEADER;
Luego necesitaremos una variable para alojar cada uno de las líneas del registro a revisar. Una vez tengamos desarrollada la estructura de datos y el algoritmo necesario para leer e interactuar con el usuario, podremos emitir órdenes con otra librería para trabajar los datos. No os preocupéis, no haremos ningún programa aquí, solo queremos que comprendáis la magnitud de la tarea.
Para ello os presentamos a Log Parser, una utilería escrita por Gabriele Giuseppini, un empleado de Microsoft® que necesitaba, al igual que nosotros, analizar los registros de uso del producto «Internet Information Service» de esa empresa. En 2001 fue liberada la versión 2.0 con licencia pública, la versión 2.1 fue incluida con el conjunto de herramientas de ISS 6.0 y en 2005 se liberó la versión actual 2.2 que se puede descargar desde el sitio web de Microsoft®. Ha ido evolucionando con el tiempo y es capaz de leer desde archivos .evt y .evtx, además de formato CSV, TSV, NCSA, W3C, y XML, puede leer los objetos de «Active Directory» y por si fuera poco soporta un modelo COM para que los desarrolladores definan sus propios formatos.
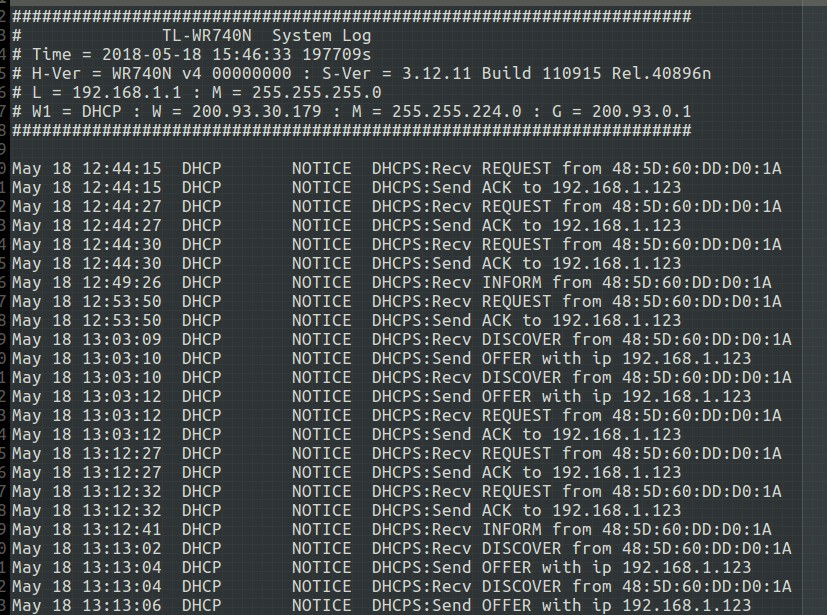
Con Log Parser podemos, tranquilamente leer y exportar un fichero con los registros de eventos de nuestro enrutador o incluso trabajar sobre registros de aplicaciones de terceros. Lo que consideramos realmente interesante de Log Parser es que tiene una sintaxis muy curiosa: podemos utilizar lenguaje SQL y exportar el resultado a un archivo separado por comas que podemos utilizar con Log Stash o dejarlos en formato .sql el cual permite luego importarlo directamente en las bases de datos. De manera predefinida soporta cinco tipos de datos: INTEGER, STRING, TIMESTAMP, REAL y NULL así que podremos hacer un preprocesamiento de datos antes de enviarlos a Log Stash. En realidad tiene muchísimas más funciones y características que no caben en esta entrada pero podéis consultar, en castellano, en este enlace.
Una vez hallamos instalado Log Parser (sí, tiene una interfaz gráfica de instalación y toma su tiempo) podremos echar mano de la terminal de comandos (con derechos de Administrador; si tienen problemas leyendo los .evtx utilicen xcopy para que trabajen en una carpeta «C:\DATOS_LOGPARSER», por ejemplo). En nuestra máquina virtual con Windows 7 que creamos en el 2015 conseguimos 79 archivos de tipo .evtx para un total de 39 megabytes y eso solamente para el sistema operativo, multipliquen eso para aproximadamente dos docenas de aplicaciones instaladas, cada una generando sus propios archivos de registros ¡tenemos mucho con que practicar!
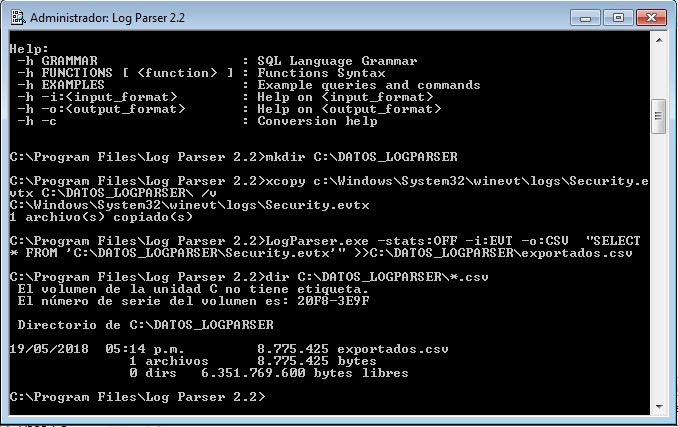
LogParser.exe -stats:OFF -i:EVT -o:CSV "SELECT * FROM 'C:\DATOS_LOGPARSER\Security.evtx'" >>C:\DATOS_LOGPARSER\exportados.csv
Analizando brevemente la línea anterior:
- -stats:OFF para que no muestre las estadísticas (no veremos los registros de eventos de Log Parser – irónicamente no deseamos más cantidad de datos ¡ya estamos trabajando con Grandes Datos! –).
- -i:EVT para indicarle el origen de los datos (de manera curiosa en realidad le pasamos un EVTX en Windows 7 y debimos haber escrito -i:EVTX, sin embargo produce el mismo resultado).
- -o:CSV el formato deseado para Log Stash, valores separados por comas.
- «SELECT * FROM ‘C:\DATOS_LOGPARSER\Security.evtx’ » la instrucción más importante porque podremos llamar campos específicos y para colocar el nombre y tipo de datos que necesitemos ¿Recuerdan el servidor SysLogServer de Pandora FMS? Pues bien acá podremos llamar las variables de la misma manera ya provenga el registro de un ordenador con Windows, Linux o Mac (cada sistema operativo tiene su equivalente, por ejemplo los muros de fuego, firewall).
- Por supuesto lo último es el nombre del fichero y lugar donde exportamos.
Para aclarar lo de los nombres de los campos, a la operación anterior la abrimos con el bloc de notas (puede tardar en abrir, incluso Microsoft Excel tiene límites en su hoja de cálculo y no mostrará todos los datos si es muy extensa). Aunque son 4 megabytes lo que nos interesa es el inicio del archivo exportado:
EventLog,RecordNumber,TimeGenerated,TimeWritten,EventID,EventType,EventTypeName,EventCategory,EventCategoryName,SourceName,Strings,ComputerName,SID,Message,Data
Tomemos por caso «TimeGenerated» tranquilamente podemos exportarlo como «TiempoGenerado» en una variable TIMESTAMP y ya estaríamos preprocesando datos para convertirla luego en información.
Log Stash digiriendo los Grandes Datos
Antes de comenzar a alimentar a Log Stash debemos crear un guion de configuración en la misma carpeta (del ordenador con Windows copiamos el fichero «exportados.csv» al ordenador con GNU/Linux ejecutando a Log Stash) al cual llamaremos «logstash_exportados.config«.
input {
  file {
    path => "/home/jimmy/datos_logstash/exportados.csv"
    start_position => "beggining"
    sincedb_path => "/dev/null"
  }
  filter {
    csv {
      separator => ","
      columns => ["EventLog","RecordNumber","TimeGenerated","TimeWritten",
      "EventID","EventType","EventTypeName","EventCategory","EventCategoryName",
      "SourceName","Strings","ComputerName","SID","Message","Data"]
    }
    mutate {convert => ["RecordNumber", "integer"]}
  }
  output {
    elasticsearch {
      hosts =>"localhost"
      index =>"seguridad_maquina_virtual_win7"
      document_tpe => "maquina_virtual_win7"
  }
}
Este archivo necesario es el que lee Log Stash para importar los datos, nótese que usamos la instrucción «mutate» para convertir en entero el número de registro: de manera predeterminada todo es considerado cadena de caracteres pero convertirlo en numérico ayuda mucho a almacenar datos de manera eficiente.
Conclusión
Con esto estaríamos listos para solicitar datos a Elastic Search (que también podemos usar con Mongoosastic para MongoDB, una base de datos NoSQL) bajo el índice «seguridad_maquina_virtual_win7» pero por medio de Kibana, la herramienta para visualizar gráficos de forma dinámica.