¡Pero es que Pandora FMS también le va el tema de la seguridad! Pues va a ser que es distinta su especialidad… pero sí, claro está, que alcanza a todo lo que es monitorización. Os explico: la flexibilidad es intrínseca a su nombre, FMS significa Flexible Monitoring System o Sistema de Monitorización Flexible y es una herramienta con la que podremos ahorrarnos muchos dolores de cabeza, ¡así como también podremos adaptarla a nuestras necesidades!
Categoría: GNU/Linux
Configurando la bandeja del reloj en Ubuntu 18.04
Somos gente práctica y sencilla y una de las cosas con las que estamos en desacuerdo en Ubuntu 18.04 es el formato de la hora («bandeja del sistema») el cual no permite ser personalizado por nosotros, en esta entrada explicamos como cambiar esa característica.
«Dos delgadas hebras de vidrio» por Rob Lanphier (Internet Archive)
Esta entrada en nuestro blog es la traducción al castellano acerca del incidente ocurrido a Internet Archive, organización que se dedica a guardar copias de las páginas web (incluido todo su material multimedia), el pasado 24 de junio de 2019.

D-Bus: aplicaciones que «hablan» entre sí
Traducción al castellano de la página de introducción al proyecto D-Bus en «Freedesktop Organization» cuya última edición de dicho documento fue efectuado el 17 de diciembre de 2018.
¿Necesitamos conocer al Lenguaje C para monitorizar?
Avezado lector, avezado lectora: vosotros ya sabéis tanto como nosotros la respuesta a esta pregunta pero ¿qué motiva esa respuesta? Hoy disertaremos al respecto, ¡estáis invitados!
El Lenguaje C es intimidante
«El lenguaje de programación C» (o, simplemente, Lenguaje C) es el título del libro publicado en 1978 por Brian W. Kernighan y Dennis M. Ritchie donde introdujeron la idea de presentar un programa de ejemplo llamado «¡Hola mundo!» y que es modelo común en casi todo tutorial para programar, sin importar el lenguaje usado.
Tal vez de allí sale la idea de omnipresencia del Lenguaje C: ese libro presentó muchos paradigmas, o al menos varios estilos de escritura que aún hoy seguimos usando. Pero también el Lenguaje C tiene un oscuro pasado que os sorprenderá…
Monitorizando nuestro Uso de Disco Rígido
Recuerdo con cierta nostalgia los discos flexibles de cinco y un cuarto de pulgada y luego los más robustos de tres y medio. Ya ni debería escribir la palabra rígido pero me habéis pillado: es para que los más jóvenes pregunten «¿pero es que cuántos tipos de discos hay?» o incluso, con el advenimiento de las Unidades de Estado Sólido (SSD), «¿Qué es un disco?». Lo cierto es que la capacidad de almacenamiento es indetenible, llegando incluso al orden de los petabytes, por lo que necesitamos la monitorización para llevar cuenta de tan monstruosas cifras, veamos.
Ocho bits hacen un byte y 1024 de ellos hacen un kibibyte
¿A que os he sorprendido, a dónde ha ido la palabra kilobyte? Históricamente en informática hemos cometido serios errores como acortar los años a dos cifras, o considerar que un kilobyte son mil bytes cuando en realidad son 1024. Vamos ¿qué diferencia hacen 24 contra mil? «Epa vejete que son casi lo mismo» me dicen pero ahora que los dispositivos de almacenamiento son gigantescos se comienzan a ver grandes diferencias.
Os explico (esto es necesario para comprender el software que veremos): un terabyte, o mejor dicho, un tebibyte son exactamente:
1 099 511 627 776 bytes
Como sabemos que el prefijo tera indica un billón, un uno seguido por doce ceros pero en este caso es 2⁴⁰ bytes: rápidamente notamos ¡que tenemos cerca de cien millardos de bytes adicionales en vez de lo que habíamos pensado!
Pongamos en perspectiva: los discos flexibles que usamos de 3½ tenían capacidad de guardar 1 474 560 letras (un byte por letra, ahora con Unicode UTF-8 esto varía según el idioma): ¡un tebibyte son poco más de 745 654 discos flexibles!
Almacenamiento en disco
Guardar y leer los ficheros tiene analogía con un libro: el índice indica dónde comienza y termina cada capítulo, sección o incluso un párrafo en particular, imágenes, prólogo, tablas, etc. Mientras más grande el libro (disco) más grande el índice (Tabla de Asignación de Archivos o FAT) y aquí viene el caso que nos ocupa ¿cómo lidiar con millones de archivos?
Supongamos que tenemos 500 millones de archivos y necesitamos conocer dónde está ubicado uno en particular, por ejemplo, uno donde se guardan determinados registros de eventos. El software libre permite modificar y que guardemos donde mejor convenga, así que aunque las aplicaciones generalmente tienen ubicaciones predeterminadas, no siempre se siguen la reglas. ¿Qué tal si decenas de fotógrafos guardan cada quien en un sistema de almacenamiento masivo sus trabajos? Los nombres de ficheros serán muy parecidos, incluso las aplicaciones con búsqueda de archivos repetidos por nombre darán falsos positivos.
Otro problema es cómo se guardan los ficheros: en racimos de 4096 bytes (8 sectores de 512 bytes) así que un archivo de 4296 bytes en realidad ocupa 8192 en disco… ¿cuánto «desperdiciamos»?
Herramienta duc
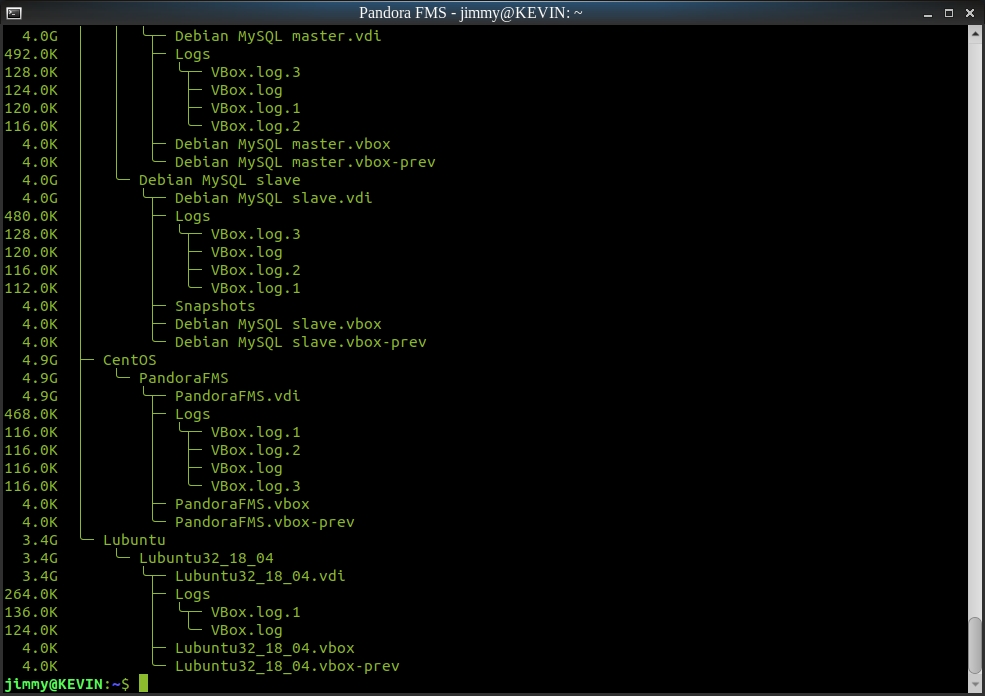
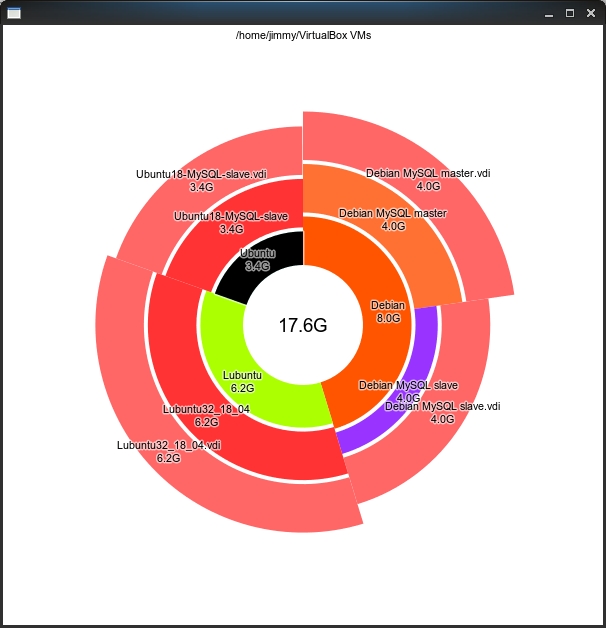
Herramient duc vista de árbol de un catálogoPara esto, y más, una herramienta comprobada para trabajar con tal cantidad de datos es duc. Es capaz de reportarnos en formato XML (uno de los tantos formatos utilizados por Pandora FMS para importar y/o exportar datos) cuánto ocupa cada fichero de «forma aparente» y de «forma real». La forma real son los sectores usados: a mayor cantidad de ficheros pequeños, mayor espacio «desperdiciado». Pero ¿cómo trabaja duc?
duc utiliza una base de datos muy primigenia llamada Tokyo Cabinet (actualmente hay una versión mejorada llamada Kyoto Cabinet) escrita en lenguaje C, con variables de 64 bits y con alta resistencia a la corrupción de datos. Y como decían los antiguos comerciales de televisión «Esperen, hay más»: ahorra espacio al comprimir sobre la marcha sin desmedro de velocidad, soporta multiprocesos y tiene opciones tales como escoger o excluir los tipos de sistema de archivo (.ext4, btrfs, etcétera).
De esta manera duc puede comenzar a indexar nuestros discos rápidamente y luego mantener actualizados y a la mano cientos de millones de registros en cuantos catálogos (bases de datos Tokyo Cabinet) necesitemos. Deberemos con cron mantener actualizados dicho(s) catalogo(s) para poder retribuir datos para su posterior monitorización.
Aparte de exportar en formato XML también dispone de varias interfaces gráficas e incluso puede servir CGI en un servidor web Apache, permitiendo CSS personalizado por nosotros, si queremos.
Herramienta stat
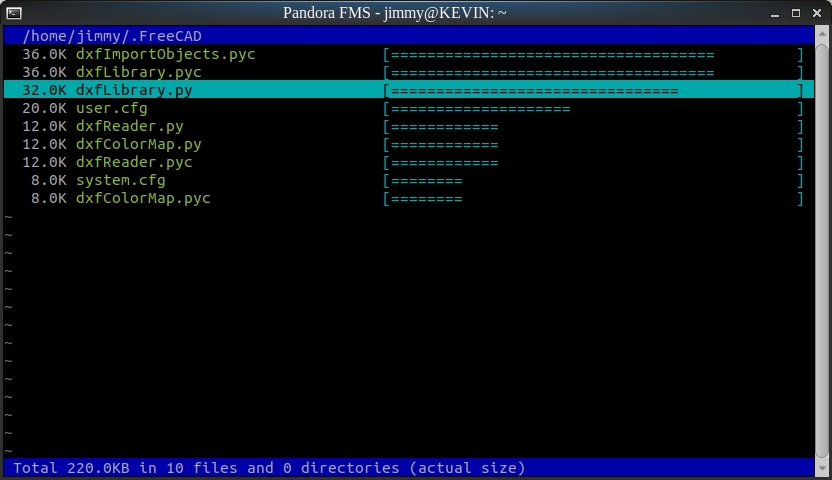
Un comando que viene en la mayoría de las distribuciones Linux, y que podremos incluso integrarlo a duc (es más fácil decirlo que programarlo) es stat, el cual nos retribuye rápidamente el propietario, las fechas de creación, acceso, modificación y cambio de estado. Para ello emplearemos el parámetro –format= acompañado de %U, %X, %Y y %Z (formato Epoch y listo para guardar en la base de datos para su monitorización). Deberemos esperar que los sistemas de archivos ofrezcan soporte para la fecha de creación, todo depende de la distro utilizada.
Son muchas las razones para hacer seguimiento a ciertos directorios o ficheros, muy alejados de la privacidad de los usuarios, porque cada aplicación crea sus usuarios virtuales y sus correspondientes ficheros. Si necesitamos conocer en tiempo real los cambios, adicionaremos a nuestro código la librería inode notify (inotify) y el propio kernel del sistema operativo nos ayudará en ese aspecto.
Herramienta duff
Acá sí que deberemos instalar en nuestros sistemas Linux ya sea con yum, apt, snap, etc. para poder tener este programa auxiliar en nuestro arsenal. Se encarga de buscar los ficheros «repetidos» con la particular característica de que crea un trozo de información virtualmente única («hash») para cada fichero. Esto crea una huella prácticamente única basada en el contenido del archivo: con un solo byte que cambie obtendremos un hash diferente, por lo que los hash son útiles para crear catálogos de respaldos «en la nube».
Así podremos saber a ciencia cierta si dos ficheros, a pesar de tener diferentes nombres, fechas, etc. tienen el mismo contenido (la posibilidad de que tengan diferente contenido con el mismo hash es una entre muchos millones -a eso se le denomina «colisión«-). Con duff podremos escoger niveles elevados de creación de hash, hasta SHA512 pero por defecto trabaja con SHA1.
Fíjense que aunque duff lee los ficheros en su totalidad, su contenido en sí mismo le tiene sin cuidado: para ello hay aplicaciones que buscan metadatos dentro de los documentos, ya sea basado en la extensión del archivo (ej. .odt, documento de texto; .xlsx, hoja de cálculo) o simplemente tanteando estructuras de datos conocidas contra el comienzo de cada fichero si no tiene extensión o si la extensión no coincide con la estructura de datos.
Un paso más allá
Tenemos tiempo escuchando acerca de los sistemas operativos que utilizarán bases de datos como sistemas de archivos (OS-BD), es decir, el enfoque de duc pero combinado con stat y duff, además de los metadatos y datos clave dentro de los documentos, que éstos dejarían de llamarse ficheros sino simplemente documentos. Por supuesto que los sistemas de archivos seguirán existiendo: si un usuario o usuaria saca de su OS-BD en una unidad de almacenamiento externo lo más recomendable es sacarlo como fichero, porque desconocemos si el otro OS maneja tal tipo de base de datos (aunque con el software libre esto es subsanable rápidamente si se cuenta con conexión a Internet). Pandora FMS está más que preparada para monitorizar base de datos, y de hecho su funcionamiento está basada en su uso intensivo.
Pandora FMS es un software de monitorización flexible, capaz de monitorizar dispositivos, infraestructuras, aplicaciones, servicios y procesos de negocio.
¿Quieres conocer mucho mejor todo lo que Pandora FMS puede ofrecerte? Entra aquí: https://pandorafms.com/es/
O también puedes enviar cualquier consulta que tengas acerca de Pandora FMS. Hazlo de una manera muy sencilla, gracias al formulario de contacto que se encuentra en la siguiente dirección: https://pandorafms.com/es/empresa/contacto/
¡El fantástico equipo que se encuentra detrás de Pandora FMS estará encantado de atenderte!
| Título | Enlace |
|---|---|
| Duc, una forma sencilla de inspeccionar y visualizar el uso del disco | https://ubunlog.com/duc-inspeccionar-uso-disco/ |
| Fundamental Specifications of Tokyo Cabinet Version 1 | https://fallabs.com/tokyocabinet/spex-en.html |
| Dolphin y otras apps de KDE mostrarán la fecha de creación de archivos | http://lamiradadelreplicante.com/2019/04/15/dolphin-y-otras-apps-de-kde-mostraran-la-fecha-de-creacion-de-archivos/ |
| DUFF un comando para detectar archivos duplicados en nuestro sistema | https://soyadmin.com/duff-un-comando-para-detectar-archivos-duplicados-en-nuestro-sistema/ |
| Título | Enlace |
Powershell Básico: conozcamos sus principales comandos
La Interfaz de Línea de Comando (abreviado en inglés como CLI) en Windows® existe y resiste el paso del tiempo. Desde aquellos días lejanos del MS-DOS® hasta el actual PowerShell® que os presentamos hoy. Veamos el PowerShell Básico.
Dependencias incumplidas en Ubuntu 18 («usted ha retenido paquetes rotos»)
En alguna oportunidad vamos a instalar alguna aplicación en Debian y derivados (acá Ubuntu 18) y recibimos el siguiente mensaje:
E: No se pudieron corregir los problemas, usted ha retenido paquetes rotos.
Hoy tocaremos este tema.
Catorce herramientas gratis de Software Libre SQL
Nuestras bases de datos (abreviado «BD«) son las que mantienen con vida a Internet, ¡eso quién puede dudarlo! Incluso se habla desde hace algunos años del desarrollo de sistemas operativos con los cuales los usuario no tiene contacto directo con los ficheros sino que sus archivos personales son guardados en una BD local. De hecho ya vemos como existen servicios en línea que realizan esto por nosotros, tal como Google Drive o Nextcloud, esta última escrita con licencia libre Affero.
Ya os hemos hablado de las soluciones para BD tanto en software privativo como libres, de tipo noSQL o SQL y estas últimas las trataremos en este artículo.
dnsmasq: DNS práctico y sencillo (con DHCP opcional)
Simon Kelley en su sitio web, y por cuenta propia, fue quien creó -y mantiene- a dnsmasq: así, sin mayúscula inicial (excepto si está al comienzo de una línea o después de un punto). Dnsmasq es exactamente lo que su creador quiso que fuera: un programa sencillo, pero poderoso, que sirve como DNS sin mayores pretensiones, especialmente creado para redes de área local y con funciones adicionales, veamos.
Publicado el domingo 28 de abril de 2019.
Actualizado el domingo 20 de diciembre de 2020.