Iniciamos operaciones en 1993 en el sur de Valencia con una maquina XT8088 con 2 unidades de floppy de 5 1/4 y un monitor monocromatico: ¡HEMOS LLEGADO LEJOS!
Sí, lo sabemos: VirtualBox es de Oracle y sí, algún día lo pueden restringir a privativo (de hecho los «complementos» tienen licencia privativa) pero vamos a seguir aprovechando este hipervisor mientras su licencia sea libre. Encontramos que es el más fácil de manejar y de ser necesario (como nos ha ocurrido antes) podremos manejarlo cómodamente por la línea de comandos. Hoy traemos su instalación en el novedoso Debian 9 Stretch en una portátil con procesador de 32 bits debido a un programita que verifica que el procesador sea de 32 bits ¡VirtualBox no lo puede engañar! (en realidad nadie es infalible).
La Cámara de Compensación Bancaria desde que tenemos uso de razón ha existido, la diferencia es que ahora es electrónica («ahora» es desde el 2007 para acá, cuando hicimos la reconversión monetaria). Muchos bancos se han ido, otros incluso han venido y se han vuelto a ir, otros los saquearon, se fusionaron, etc. Más adelante explicaremos en qué consisten los 20 digitos de las cuentas bancarias en venezuela, por ahora nos meteremos de lleno con los códigos, hacer esta entrada resultó cuando tuvimos la agradabel sorpresa de encontrar esta página donde los escribieron en código HTML objeto tipo combo (ordenado por nombre alfabéticamente).
phpIPAM, como su nombre compuesto lo indica, es el manejo y administración, por medio de lenguaje PHP, de las direcciones del Protocolo de Internet (en inglés «Internet Protocol Address Managament» y que abreviaremos como IPAM), lo que hace al software con un nombre muy singular, pnemotécnico pues (¿metanombre?). En este artículo revisaremos cómo podremos utilizar phpIPAM más bien como una herramienta auxiliar, aunque veremos que tiene ciertos componentes basados en la monitorización, ¡vamos!
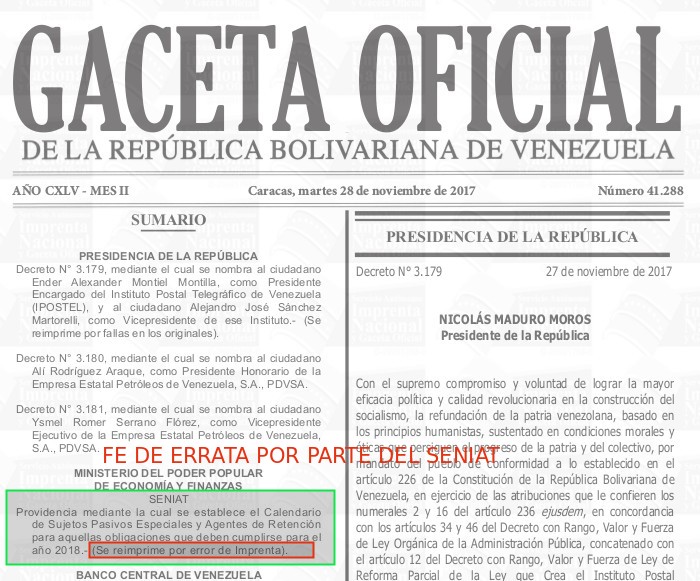
El año se fue volando y ya tenemos encima el año 2018 es por ello que hoy en Gaceta Oficial N° 41.287 publicada el glorioso día lunes 27 de noviembre la Providencia Administrativa SNAT/2017/0053 donde se establecen exactamente los días de pago de los Contribuyentes Especiales (conocidos en la jerga legal como «Sujetos Pasivos Especiales y Agentes de Retención»).
¿Apurado o apurada?
FE DE ERRATA DEL SENIAT:haga click aquí para descargar la Gaceta Oficial N° 41.288 con solo 3 hojitas: sumario y calendario.
Haga click aquí para descargar la Gaceta Oficial N° 41.287 (error del SENIAT al pasar la información a Imprenta Nacional).
¿Han notado que la barra de direcciones de Mozilla Firefox TAMBIÉN busca a pesar que ya tenemos el cuadro de búsqueda habilitado? Afortunadamente dicho comportamiento puede ser CORREGIDO con dos simples comandos (las imágenes y ejemplos aquí mostrados pertenecen a Mozilla Firefox 57.0 en Ubuntu 16.04).
¡Qué molesto es que en la barra de direcciones de Firefox TAMBIÉN salga el cuadro de búsqueda aún cuando YA lo tengo a éste habilitado! Si quiero buscar uso uno, si quiero navegar uso otro ¡son diferentes! ¡AFORTUNADAMENTE LO PODEMOS CORREGIR!https://t.co/O7oFFtycP2 cc @skatoxpic.twitter.com/uLRyVhHP9v
Esta oportunidad es para traerles en castellano el magnífico relato de Georgios Konstantopoulos, empleado de la empresa Honda en Alemania, ingenireor y ahora estudiante y entusiasta de las tecnologías informáticas. Como cosa extraña el artículo está en idioma inglés y no en alemán, ya sabemos que el inglés ahora es como el latín del Imperio Romano: una lengua franca, nos guste o no. La cuestión es que hablamos castellano y hay que extender el conocimiento y así completamos el círculo: por eso es que no está escrito en alemán (ni tampoco en griego, idioma natal del sr. Konstantopoulos). En este punto ya queda completamente claro que no es de nuestra autoría el siguiente artículo, que es una traducción aderezeda así como un merecido reconocimiento a las habilidades y obra del sr. Georgios ?¡a su salud!?
¡Hola! En una anterior oportunidad, por este vuestro blog, os desglosamos en 17 categorías las mejores herramientas de red para gestionar vuestra red (en idioma inglés) e incluimos a Graylog2 como software administrador de registros. También os publicamos un artículo sobre monitoreo de red (en castellano) con sus definiciones y características y disertamos sobre el monitoreo de red básico: en esta categoría ubicaremos a Graylog2 y para el monitoreo de red avanzado a Pandora FMS. Es por ello que este artículo es meramente comparativo: estamos tratando de cotejar peras con manzanas pero con propósitos didácticos nos embarcamos en esta singladura ¡vamos!
Breve historia de syslog y Graylog2
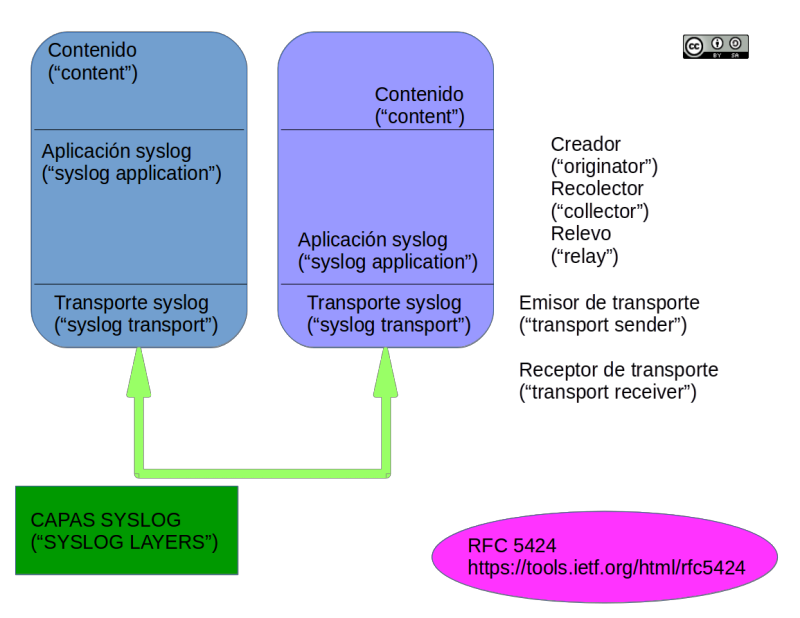
Para poder conocer el funcionamiento de Graylog2 debemos saber qué es syslog, piedra angular del software que hoy nos ocupa. La historia se remonta a 1981 cuando Eric Paul Allman trabajaba en la Universidad de California en Berkeley y escribió el software Sendmail, prácticamente el padre del correo electrónico moderno, y necesitaba un pequeño programa que le informara de los acontecimientos en cada servidor que ejecutara Sendmail. Ya UNIX, integrado en su propio kernel, tenía la capacidad de generar sus propios mensajes (incluyendo mensajes de alerta) y que eran guardados en archivos de texto dentro del sistema de ficheros. Eric Allman desarrolló un programa de servicio («daemon» en inglés o demonio en castellano) llamado syslogd encargado de leer los archivos con dichos mensajes guardados y estableció el protocolo syslog para enviarlos a otro ordenador (llamado colector) para analizar los datos. Pueden ampliar sus conocimientos si leen la norma RFC 5424 acerca de las capas y su esquema de funcionamiento (nota: la norma indica que tranquilamente todos los componentes de syslog pueden residir en un único ordenador, sin embargo la imagen ilustra sobre dos ordenadores que se comunican de alguna manera. Tampoco debemos confundir syslog con syslogd).
syslog capas según norma RFC5424
De hecho syslog se volvió tan popular que pronto nació la necesidad de que el colector no solo llevara los registros del servidor que ejecutara Sendmail sino que incluso recibiera los registros de los clientes que se conectaran a ese servidor de correo, ya que fusionar cronológicamente ambos documentos, de manera provisional, ayudaba – y aún ayuda – a rastrear errores en el código. De ese punto el darle a syslog un proposito totalmente distinto para elq ue fue creado restaba solu un paso y rápdiamente fue dado. He aquí los albores de la monitorización de red a nivel muy básico y Graylog2 es uno de los tantos programas que se encargan de ello y que más adelante veremos con detalle su funcionamiento.
Graylog2 nació de la mano de Lennart Koopmann a mediados de 2009 debido a su obervación de los altos costes de licencia del software de monitoreo, así que él decidió escribir uno propio. En sus propias palabras asegura que la oferta en ese sector de código fuente abierta era nula, pero os aseguramos que Pandora FMSestaba en su versión 3.0.
Su página web oficial es www.graylog2.org (aunque la página web redirige automáticamente hacia www.graylog.org) y su cuenta en Twitter es @Graylog2 . Este cambio de nombre, ese detalle de quitarle el número «s», ocurrió el 16 de enero de 2015 al sacar la versión 1.0 (beta). A lo largo de este artículo usaremos preferentemente su nombre original Graylog2 ya que incluso grandes empresas de alojamiento web lo conocen como Graylog2 (y recomiendan su uso). Es entonces que en estos dos últimos dos años ha registrado un aumento explosivo de usuarios y el 27 de abril de 2016 liberan la versión 2.0 y al momento de escribir estas líneas está vigente la 2.3.2 (19 de octubre de 2017) que será la que revisaremos.
Funcionamiento de Graylog2
El registro de mensajes por parte del kernel de los sistemas operativo en ficheros de texto plano, tanto en software privativo como software libre, estará con nosotros durante mucho tiempo y a eso apuesta de seguro Graylog2 ¡pues bien comencemos por hablar de seguridad y rentabilidad!
syslog, syslog-ng, rsyslog, logrotate y nxlog
Graylog2 por ser software libre no es para nada una «caja negra» manejada por terceros sino por nosotros mismos, así que los datos que le entreguemos a este programa pues es responsabilidad nuestra, única y exclusivamente.
Teniendo esto en mente, nuestras necesidades de monitoreo son para muchos dispositivos ya sea dentro de nuestra red de área local o en el resto del mundo y syslog solo establece el envio de información por parte de paquetes UDP. Los cuales no ofrecen «acuse de recibo» ni «estrechamiento de manos» («handshaking» en inglés) así que no podremos usar un protocolo seguro de encriptamiento para garantizar que nuestra información no caiga en manos de terceros. Tal vez se nos ocurra instalar red privadas virtuales («VPN» en inglés) a diestra y siniestra para enviarlos pero incluso así un dispositivo cualquiera seguirá enviando información, así se haya caido la comunicación o incluso nuestro servidor Graylog2 esté apagado o fuera de servicio, tal escenario no conviene a nuestros propósitos.
Es por ello que aparte de syslog han surgido soluciones que envíen por paquetes TCP -que pueden implementar protocolos seguros y garantizan la entrega de cada uno de los paquetes enviados- amén de otras características adicionales, como por ejemplo entregarlos directamente en un motros de base de datos como MySQL o preprocesamiento de ficheros e incluso su nomenclatura de nombres para guardar de manera ordenada muchos dispositivos. syslog-n existe desde 1998, tiene versión libre y una versión empresarial (esta última con módulos adicionales) y está disponible para las grandes distros de Linux e incluso hay una versión para Windows bajo Cygwin, software que permite una emulación de Linux en Windows. Pero claro, hay muchas otras alternativas sin embargo nos enfocaremos en rsyslog que surge en 2004 por mano de Rainer Gerhards en competencia directa con syslog-ng y hoy en día viene preinstalado en Debian, en CentOS y similares está presente en los repositorios oficiales y Ubuntu 16 («distro» de Debian) lo trae por defecto como parte de una utilería mayor: Logrotate. Para efectos prácticos los registros de eventos de cada ordenador, una vez hayan sido enviados a Graylog2, pues poco nos importa el destino final de esta información: por el contrario, es una trabajo menos que no tendremos que lidiar en neustra labor de administrar y/o monitorear redes.
¿A dónde vamos con toda esta explicación y qué diantres tiene que ver con Graylog2? Pues que todo esto que os contamos lo repetiremos cuando veamos su funcionamiento por la analogía en cuanto al manejo de la información recibida -y almacenada-. Pues bien logrotate, como su nombre en inglés sugiere, se encarga de rotar y comprimir y además de podarlos periódicamente ya que de no hacer esto nuestros discos duros eventualmente se llenarían. En el caso del sistema operativo privativo Windows desde la versión 2000 (y todos sus sucesores) tienen su propio servicio integrado de:
Registro de eventos de las aplicaciones (por ejemplo, el fallo en acceder a una base de datos con MS SQL).
Eventos relacionados con el Active Directory, una tecnología que permite adminitrar cientos de ordenadores por medio de dominios con ayuda de DNS ¡imaginad la cantidad de datos generados por uno de estos servidores que maneje un árbol o un bosque completo de dominios!
Eventos relacionados (en categoría aparte) con los DNS, manejen o no algún Active Directory.
Replicación de archivos, suerte de respaldos distribuidos que se sincronizan entre sí.
Seguridad: para el caso de los administradores todo lo relacionado con los accesos al sistema operativo talaes como manejo de usuarios, ingresos fallidos de contraseña, etc.
Por último lo más importante: los eventos relacionados con el sistema operativo y su interacción con el hardware, tales como S.M.A.R.T. de los discos duros, tiempo en servicio, reinicios y apagados forzosos, etc.
Incluso podemos grabar nuestros propios eventos de prueba en Windows, con las debidas credenciales de administrador en la línea de comandos podemos practicar los siguiente:
eventcreate /s nombre_servidor /t ERROR /id 100 /l APPLICATION /d "Un registro de evento, como prueba"
El comando eventcreate se encargará de grabarlo para luego transmitirlo a nuestro servidor Graylog2. Ya que de nuevo tocamos el tema de la transmisión, en Windows podremos instalar una solució de código abierto con este propósito: Nxlog . Esta aplicación está disponible tanto para Windows como para Unix, Linux, BSD y Android: el registro de eventos del sistema operativo como la de las aplicaciones (correctamente programadas para ello). ¿Cómo saber cual es cual? Volvamos a lo último que vimos sobre crear nuestros propios eventos en Windows (en otros sistemas oeprativos transcurre de manera similar) con los parámetros «/t» y «/l» a continuación le pasamos la severidad y origen del mensaje de registro, veamos:
Parámetro «/t»:
ERROR
WARNING
INFORMATION
SUCCESSAUDIT
FAILUREAUDIT
Parámetro «/l»:
APPLICATION
SYSTEM
Graylog2: funcionamiento y requisitos
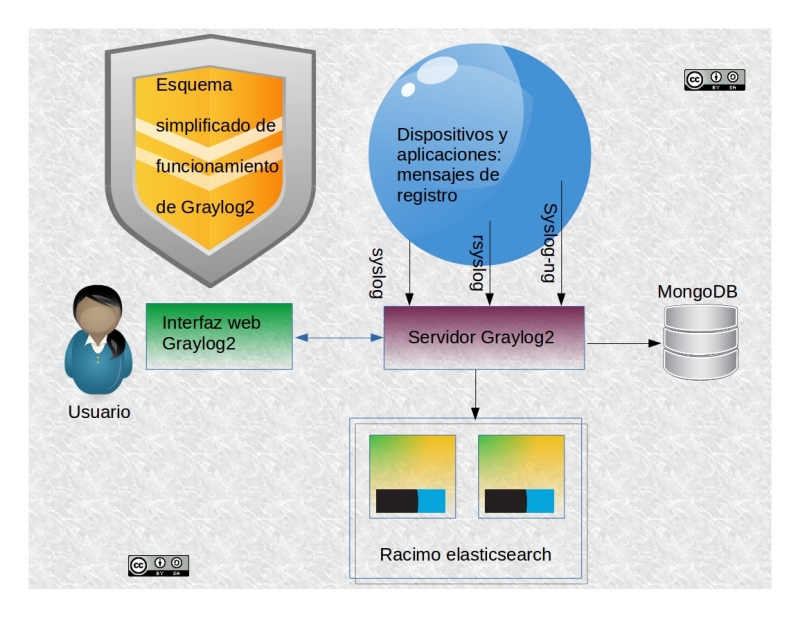
Acá si ahorraremos tiempo: el funcionamiento de Graylog2 y su instalación está íntimamente relacionados, creamos este esquema simplificado no recomendado más que para simples pruebas, en un ambiente de producción imposible usarlo de esta manera.
Graylog2 esquema simple de funcionamiento
Con la imagen como abreboca arrancamos con los requisitos de instalación (funcionamiento incluído), aclarando que solo lo instalaremos en un anfitrión Linux ya que no se recomienda para nada hacerlo sobre Windows:
Graylog2 como tal, en su componente de servidor, está programado con Java así que necesitaremos mínimo Java SDK 8. Se encargará, en esencia, de recibir los registros de los otros dispositivos (sin datos de origen no hay proceso alguno que valga).
Elasticsearch , basado en Apache Lucene, y ambos escritos por completo en Java (en su versión v2.X pero no una versión superior con Graylog2 v2.2). Este componente será el encargado de realizar el trabajo pesado, tanto es así que incluso en un esquema simplificado no dejamos de dibujarlo con racimo («cluster») y no es para menos: Elasticsearch es un programa que recibirá TODOS los registros y hará todo lo necesario para desglosar, clasificar, relacionar y almacenar la información sin importar en que formato vengan (maneja una gran variedad de protocolos). Recalcamos que será aquí donde reposarán nuestros datos y necesitaremos varias máquinas, el trabajo es fuerte y Graylog2 lo sabe y maneja el siguiente esquema de trabajo: los usuarios (empresas) generalmente utilizan los últimos 30 días de registro y hasta por un máximo de un año es lo que recomiendan para que el sistema no se vea resentido en su desempeño (Pandora FMS, a diferencia, mantiene migrando constantemente sus datos con un «servidor de predicción» de manera transparente a sus usuarios: usted es quien decide cuándo eliminar información; además en la versión empresarial contará con servidor Goliat para mover y migrar datos realmente grandes). ¿Recuerdan que hablamos sobre logrotate? Pues bien para ese trabajo en Graylog2 ofrecen en la versión empresarial el servicio de resguardo de datos (comprimidos, encriptados y transportados por internet con protocolo seguro para proteger la privacidad de los clientes) con la promesa que podrán ser reimportados cuando sean requeridos a solicitud (también está incluído el contacto directo con los ingenieros y programadores de Graylog2 más un servicio de auditoría de las acciones de usuario cuya información se guarda ¿en cuál base de datos? Pues pasemos al siguiente punto).
Si en Pandora FMS necesitamos uno y solo un motor de base de datos (MySQl) en Graylog2 necesitaremos instalar, además de Java y Elasticsearch, el software MongoDB para todo lo relacionado con el acceso de los usuarios por el componente de la interfaz web (HTML más CSS y JavaScript) y algo mucho, muchísimo más importante: las condiciones de alerta que queremos nos sean informadas de manera inmediata comenzando así, de manera seria, las labores de monitoreo básico.También MongoDB nos permitirá almacenar nuestros perfiles de indexado para Elasticsearch para, consideramos nosotros, labores de auditoría o minería de datos (por ejemplo, el buscar los registros sobre una aplicación particular en un dispositivo particular para observar su desempeño o cambios en su configuración). Graylog2 se encargará de eliminar automáticamente los índices que hayan cumplido su ciclo de vida útil, e incluso recrearlos a solicitud.
¿Filtrando o seleccionando información?
A primera vista parece lo mismo pero atentos todos y todas al concepto: con Elasticsearch tenemos una poderosa y hambrienta locomotora por ingerir grandes cantidades de carbón y agua, si no hacemos esto terminaremos con toneladas de hierro frías y estáticas, lo cual no es útil para nada. Consideramos que Elasticsearch como herramienta de auditoría e incluso minería de datos es una gran ayuda nunca deberemos el dejar de alimentarla.
¿Recuerdan a rsyslog? En el archivo de configuración que llamaremos «60-graylog.conf» agregaremos lo siguiente:
El asterisco-punto-asterisco del principio indica enviar todo al servidor Graylog2 y eso genera una gran cantidad de tráfico de datos, ¡aún a pesar de estar comprimido! Por el contrario Pandora FMS delega el envío en Agentes Consola (utilizan normas reconocidas y aceptadas, ya vienen en los dispositivos a monitorear) y en Agentes Software con una amplia variedad de opciones a monitorear (temperatura del equipo, estado de un servidor web o servidor de base de datos) y de esta manera seleccionamos la información que realmente nos interesa conocer. ¡Atención, no decimos que el resto de los datos no sea importantes, no nos vayan a interpretar mal por favor! Simplemente manejamos el concepto que hay cosas realmente importantes a monitorizar, prioritarios (Pandora FMS tiene perfiles prefijados para cada tipo de cliente, configuraciones que se consideran típicas ¡y en la versión Empresarial hasta somos capaces de crear un agente a su medida y necesidades!).
Para dar sustento a nuestra afirmación anterior, en Graylog2 a partir de la versión 2.x crearon un «Proceso de tuberías» en los cuales debemos configurar los siguientes elementos:
Tuberías «pipelines».
Reglas «rules».
Conectores de flujo «stream connections».
Funciones «functions«.
Una vez hallamos establecido todo esto es que podremos proceder a filtrar la información que llega al servidor Graylog2 para que el servidor mismo no procese absolutamente nada que no cumpla con lo prefijado (y mucho menos pase a Elasticsearch).
Podremos concluir en esta sección que filtrar implica «mover» todos los datos para entonces quedarnos con los que nos interesa y seleccionar -el enfoque de Pandora FMS- es extraer la información que nos interese: con ambos métodos obtenemos el mismo resultado pero a muy diferentes costos.
Extendiendo las capacidades de Graylog2
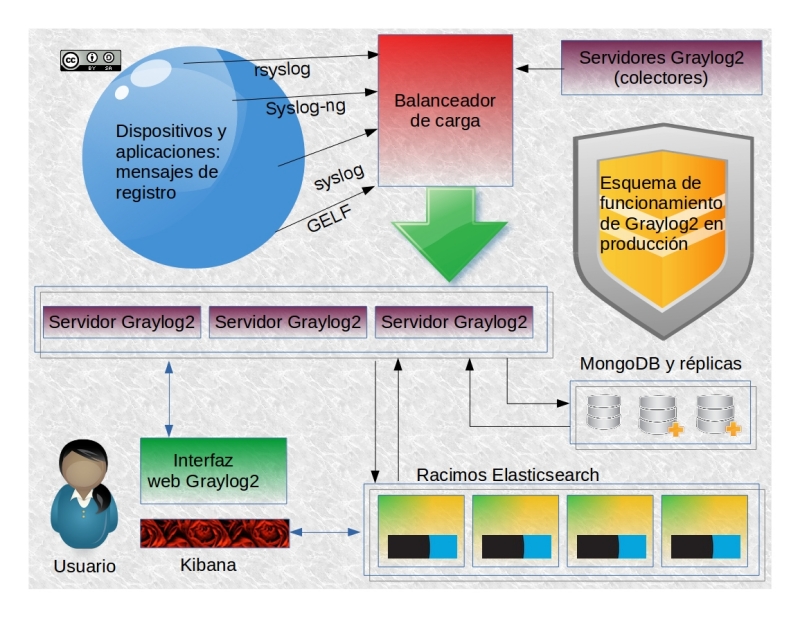
Graylog2 esquema de funcionamiento en producción
Si os pareció complicado hasta ahora, os recordamos que apenas es un ejemplo básico, incluso lo podremos montar en un dispositivo como Azure pero en la vida real, en un entorno de producción, debemos agregar más, mucho más a Graylog2.
No dejamos de repetirlo: para que Graylog2 crezca lo primero que debemos hacer es montar más racimos «clusters» para el funcionamiento de Elasticsearch y su motor de base de datos.
Para MongoDB deberemos instalar réplicas para aumentar su confiabilidad sin embargo no veremos mejora en su desempeño.
Otra ventaja de tener a Elasticsearch es el poder utilizar otros productos de la misma compañía tales como Logstash, un potente transporte y filtrados de datos (por supuesto en formato Elasticsearch) para otros servidores Elasticsearch que ejecuten o no a Graylog2. También podremos usar Kibana para fantásticas y maravillosas representaciones gráficas… pero deberemos adquirir una solución aparte para el manejo de usuarios, cosa de la cual sí se encarga Graylog2 con ayuda de MongoDB (y en la versión empresarial el proceso de auditoría de usuarios).
Si necesitamos monitorear varias redes de área locales desperdigadas por todo un país o a lo largo y ancho del globo terráqueo, deberemos instalar un Servidor Graylog2 que recoja los datos en dicha red de área local para luego enviarlos por internet; ¿recuerdan la diferencia entre filtrar y seleccionar? Pues éste sería el momento de aplicarlo antes de enviarlo a un servidor central (Pandora FMS es capaz de lidiar con este asunto con un ligero «servidor satélite«, el cual es especializado y a la medida para este trabajo, con Graylog2 practicamente deberemos instalar de nuevo la solución completa).
Otras soluciones que podremos optar, relacionado con el punto anterior:
Instalar Windows Servers 2008 o superiores e instalarles «Windows Event Collector Service» para recoger los datos de una red de área local y a esos servidores a su vez colocarles Nxlog y así tener un granja de servidoresGraylog2 que centralizen las operaciones.
Instalar «Graylog Collector Sidecar» y utilizar la API integrada de Graylog2 (en Pandora FMS esto no es necesario porque tiene sus propios Agentes Software).
Graylog2 apuesta fuertemente por su propia norma de envio llamada GELF (Graylog Extended Log Format) que permite envio de mensajes más de 1024 bytes bien estructurados, «predigeridos» diríamos nosotros, y se pueden picar hasta en 128 trozos para enviarlos comprimidos en protocolo UDP (el cual dijimos que es inseguro). Lo que impide enviarlos comprimidos por TCP es el delimitador de null en el formato Json, lo cual también ha traido problemas con Logstash, la solución por ahora es el «Graylog TcpLogstashOutput Plugin«, una utilería desarrollada por terceros y que añade una labor a nuestro trabajo de monitorización.
Todas estas utilerías disperdigadas han tenido cobijo bajo el «graylog marketplace» donde se encargan de categorizarlos y alamcenar los enlaces correspondientes para que los usuarios los integren a Graylog2
Ya dijimos que el envio de todos los registros para su posterior filtrado cuando llegue a un servidor Graylog2 será una gran cantidad de datos así que se recomiendan balanceadores de carga para la granja de servidores, así tendremos todo en un solo sitio con un mejor desempeño tolerante a fallos (por el contrario, el tener un servidor Graylog2 dedicado por cada zona geográfica obtendremos siempre unos servidores más ocupados que otros e incluso algunos ociosos, balancear la carga los manteniene a todos siempre activos y trabajando para nosotros).
Tanto Pandora FMS como Graylog2 tiene soporte para autenticación LDAP o Active Directory.
Conclusiones.
Definitivamente que Pandora FMS y Graylog2 tienen algunas similitudes a la hora de la recolección de data, teniendo en cuenta el filtrado de datos contra la selección de datos, sus maneras de trabajar son bien distintos: mientras Graylog2 descansa en gran medida sobre productos de terceros con dos motores de bases de datos para distintos juegos de infromación, Pandora FMS utiliza un solo motor de base de datos que se puede replicar tranquilamente con absolutamente toda la información en un solo sitio y recoge los datos de primera mano de una forma muy bien seleccionada. En Pandora FMS la flexibilidad también implica sencillez, en contraste con la complejidad de Graylog2.
Si os a gustado este artículo y consideras que falta algo o debemos corregir algún detalle no dudéis en comentar más abajo donde gustosamente atenderemos vuestra interactividad.
Una forma de trabajar que debería ser el norte de todos los que administramos sistemas Linux y acá su razonamiento (traducción al castellano del artículo publicado en inglés por Ramesh Natarajan en «The Geek Stuff»). Las siguientes son las 12 razones por las cuales un administrador de sistemas «perezoso» es el mejor administrador de sistemas:
Debierían haber pasado tres meses para un nuevo aumento del ingreso mínimo pero fue necesario acelerar ante la brutal escalada de precios, tanto es así que el gobierno anunció un nuevo billete del cono monetario: el billete de cien mil bolívares. En lo que respecta a la base de datos ya de unos meses para acá habíamos previsto la retirada del billete de cien pero éste se mantiene vigente hasta nuevo aviso. Una tabla de la base de datos lleva el cono monetario vigente para las diversas operaciones monetarias así que allí agregamos un registro más, y también el valor del ingreso mínimo legal, que fue modificado pues estró en vigencia desde el 1° de noviembre de 2017.
Esta es la Gaceta Oficial con el aumento del salario mínimo y bono de alimentación (+PDF y JPG) https://t.co/RdIoJAEVEB
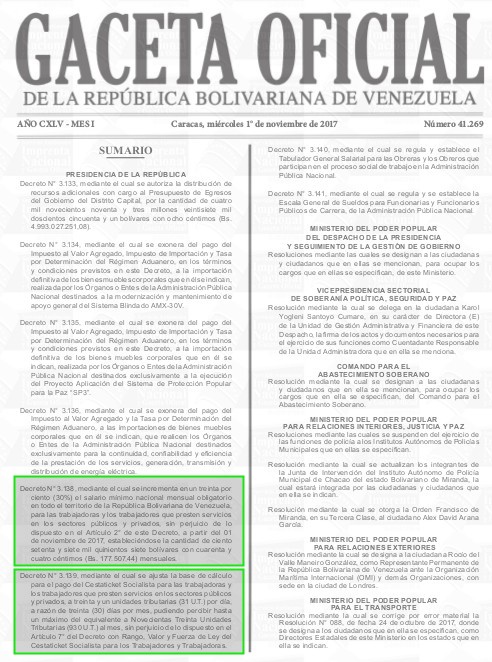
En esta oportunidad el Tribunal Supremo de Justicia batió un registro histórico en la publicación de la Gaceta Oficial lo que permitió que los demás sitios web pudieramos replicar la información. Nos enteramos por medio de la cuenta Twitter del Licenciado en Computación Luigino Bracci Roa y su artículo en Alba Ciudad contiene también una copia completa del ejemplar, unos 22 megabytes y pico. En estos días muchos y muchas pensarán que no es nada pero nosotros, siendo austeros siempre, publicamos la versión reducida con solo cinco páginas conteniendo exactamente los Decretos 3.138 y 3.139 con el aumento del salario mínimo y la cestaticket socialista.
Desde esta vuestra humilde página web lo pueden descargar del siguiente enlace:
IBM® Tivoli® Netcool ® forma parte del «Tivoli Management Framework (TMF)», y ambos pertenecen a la miríada de productos de la más que centenaria empresa denominada «International Bussines Machines» o simplemente IBM®, como la conocemos hoy día. Recordemos que esta empresa fue la encargada de automatizar los censos poblacionales en los Estados Unidos de América en el siglo XIX (para ese entonces su nombre era «Tabulating Recording Company»1 y aún no se había aventurado fuera de su propio país) y fue la responsable indirecta de masificar la computación personal («Personal Computing» o PC) en el siglo XX (papel protagonista que tomó, aprovechando las oportunidades, la empresa Microsoft para afianzarse por muchos años en el mercado). No es de extrañarnos, entonces, que tengan una solución para todo tipo de empresa a lo largo y ancho de este planeta: son muy organizados, esquematizados y muy bien documentados. Tanto es así en este último punto, lo que para sus empleados es natural (informes de cientos e incluso miles de páginas) para nosotros nos produzca un mar de información aparentemente inconexa.
La guía de implementación «IBM® Netcool ® Operations Insight Version 1.4» ocupa 292 páginas en formato PDF, está escrito por cinco autores y pesa 12 megabytes, estamos hablando del manual, ¡la guía rápida!2 Tan grande es esta corporación que la división llamada RedBooks® es la encargada de categorizar, publicar en línea (o en papel, si lo necesitamos) de manera pública y expedita todo lo relacionado con la documentación de sus muy diversos productos. Esta división y especialización del trabajo la mencionamos de manera obligada porque más adelante veremos que el software está fuertemente orientado al trabajo en equipo y colaboración entre departamentos tanto de la empresa cliente como la propia IBM®.
En esta entrada simplificaremos al máximo pero no será pequeño el texto, como tampoco lo es el Gigante Azul(«Big Blue»)1, nombre con el cual también es conocida esta empresa por todo el planeta.
IBM® Tivoli® Netcool ®
Primero deberemos aclarar que «IBM® Tivoli® Netcool ®» como la presentamos, pues no, no es su nombre exacto y completo. Para mayor precisión, el concepto que abstrae en una sola piedra angular toda esta tecnología que IBM® presenta como una solución completa es «IBM Netcool Operations Insight«®. A lo largo del tema nosotros podremos simplemente denominarla y referirnos a ella, ya sea como un todo o uno o más de sus componentes, como Netcool ® tal como se le ha abreviado en sus más de 25 años de existencia en el mercado corporativo.
«IBM Netcool Operations Insight»® integra la gestión de infraestructuras y operaciones en una sola estructura coherente entre aplicaciones de negocio, servidores virtualizados, protocolos y dispositivos de red, protocolos de internet y dispositivos de seguridad y almacenamiento.
La solución incluye los componentes siguientes:
IBM® Tivoli® Netcool ®/OMNIbus.
IBM® Tivoli® Netcool ®/Impact.
IBM® SmartCloud Analytics®.
IBM® Tivoli® Netcool ®/OMNIbus Insight Pack for IBM® SmartCloud Analytics®.
IBM® Tivoli® Netcool ®/OMNIbus Message Bus Gateway.
IBM® Tivoli® Network Manager IP Edition ®.
IBM® Tivoli® Netcool ® Configuration Manager.
Jazz for Service Management®.
Cada uno de estos componentes se instala por separado3, cada uno tiene su manual de procedimiento e implementación pero una vez que ya están todos instalados ¿podemos echar manos a la obra y comenzar así a monitorizar nuestra red? Pues no, aún falta «Netcool ® Network Management» : esta solución única combina «IBM® Tivoli® Netcool / OMNIbus»®, «IBM Tivoli Network Manager»® e «IBM Tivoli Netcool Configuration Manager»® (se debe configurar las comunicaciones entre productos para que pueda funcionar)4.
«Netcool Network Management»®
«Netcool Network Management»® es un conjunto integrado de herramientas de gestión de red, que proporcionan descubrimiento de red, supervisión, gestión de sucesos y configuración. Permite una visión centralizada que incluye creación de informes, permite supervisar la red tanto en su desempeño, despliegue y cambios, amén de la gestión y manejo de errores.
Está pensada para dar servicio a millones de eventos por día incluyendo redes físicas y virtuales, mantiene y maneja las operaciones de los distintos componentes que instalamos y centraliza los reportes. Pero quizás la tarea más significativa, dicho en propias palabras de la empresa: «Muestra líneas base de índice de sucesos, previsiones y tendencias que permiten identificar problemas subyacentes y le ayudan a afrontar los problemas de forma proactiva.»
Esto último lo presentan y lo integran como «Inteligencia Artificial» y «Computación en la nube», un enfoque no solo correctivo sino que a la vez es manejado de manera preventiva.
Modo de funcionamiento.
A pesar de toda la grandilocuencia que presenta el software, en última instancia, observamos que Netcool ® , luego de toda su laboriosa instalación, presenta los mismos elementos comunes que la mayoría de programas dedicado a la monitorización de ordenadores: lo destacable es la magnitud que asume el programa, que de hecho da por cierto y real que la empresa que lo contrata es de gran nivel y a escala planetaria.
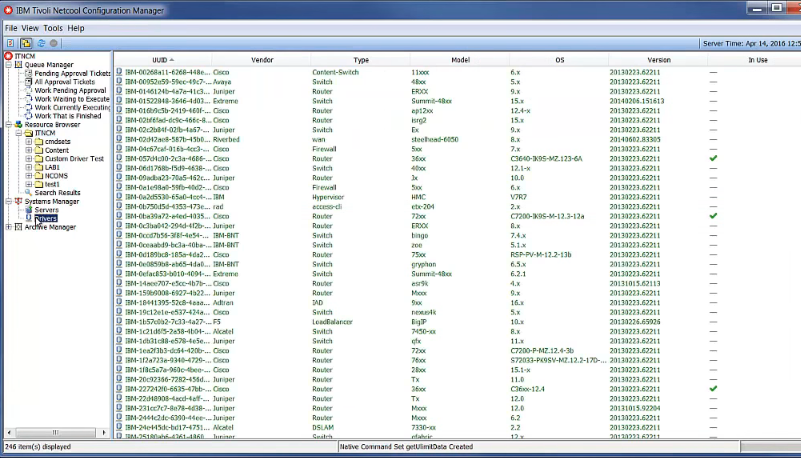
Por ejemplo, para agregar un elemento controlador personalizado para monitorear un servidor GNU/Linux5, utilizaremos el «IBM Tivoli Netcool Configuration Manager»®, opción «Tools» y luego «New driver» tras lo cual se abre un cuadro de diálogo guiado al cual le indicamos que deseamos utilizar una plantilla de IBM basado en Telnet o SSH. A continuación llenamos de detalles la ficha del nuevo controlador (sistema operativo, versión, etc.) siempre separando por medio de comas si va a tener el propósito de usufructar diferentes versiones, avanzamos a la sección de guiones de dispositivo («IT MCM communications handle») y bien podemos agregar nuestro propio código, que lo permite, o utilizamos el de algún dispositivo que tenga similar conexión, como por ejemplo un enrutador. Esto último pareciera que no se debe hacer ya que no se corresponde con la realidad pero recordemos que estamos especificandola manera de conectar al dispositivo y no estamos describiendo al dispositivo en sí mismo, que eso lo hicimos claramente al principio.
IBM Tivoli Netcool Configuration Manager® Imagen N° 1.
Lo siguiente que debemos hacer es remover el código correspondiente a la conexión a un enrutador pero que NO es compatible con el servidor GNU/Linux que necesitamos monitorear. Esto es posible porque utilizamos una plantilla la cual es copiada automáticamente, y ya forma parte, del controlador que estamos creando. Finalmente agregamos los comandos de ejemplo que deseamos que realizen el trabajo para luego recolectar la información:
La siguiente sección informará cómo se conectará al servidor GNU/Linux, si envía o recibe y envía información, así como una multitud de detalles que deberemos adecuar (este asistente es muy general para permitir el conectar una cantidad masiva y distinta de dispositivos y aparatos, debemos cuidar muy bien que seleccionamos; todo está muy bien documentado).
Al finalizar de crear el elemento controlador personalizado debemos proceder a importarlo al esquema de trabajo: la dirección IP del dispositivo a monitorear, credenciales, horario, etc. De una vez podremos ejecutarlo y ver inmediatamente el resultado en consola, analizarlo y si es necesario corregirlo (el guion) para dejarlo establecido y monitoreando.
Como podemos ver no es muy diferente a la creación de lo que en PandoraFMS llamamos plugin remoto y su creación y registro6, con la diferencia de que con Netcool ® el proceso es mucho más robusto, con una cantidad de pasos adicionales y multitud de detalles. Esto es así porque debemos recordar que IBM® tiene experiencia como fabricante de hardware y toda esa experiencia acumulada durante años y años se ve reflejada (y utilizada en provecho) en cada aspecto de su software.
Almacenamiento de resultados y datos recolectados.
Una vez que tenemos los agentes recolectores de datos pues necesitamos almacenarlos para su posterior análisis. A tal efecto está destinado a trabajar el «Netcool OMNIbus»® para llevar el «Database Gateways»7 que consiste, esencialmente y sin entrar en mayores detalles, en una base de datos para reportes y una para auditoria. La diferencia entre ambas es que para la auditoria cada adición, modificación o eliminación de un componente genera un registro mientras que en la de reportes son acciones realizadas para un componente.
Para reportes se puede escoger entre las siguientes tecnologías: Oracle®, Sybase®, MSSQL®, DB2®. Por otra parte en auditoría también podemos usar dichas bases de datos y, además, Informix® y MySQL®.
Se incluye conectividad adicional mediante tres componentes8:
Oracle gateway : Oracle libraries.
ODBC gateway : DataDirect ODBC drivers.
JDBC gateway : vendor-provided JDBC drivers.
Esta última, JDBC (Java Database Connectivity) es la recomendada por ser históricamente utilizada y es la puerta de entrada para cualquier software de terceros (área de auditoría) el obtener los datos necesarios.
Forma de trabajo de Netcool ®.
Como recién vimos, es larguísimo el describir esta suite de monitoreo informático, porque fue creada de tal manera que se integre de manera necesaria con los demás productos de la compañía. De seguir así no terminaríamos este artículo y muchísimo menos podríamos hacer una comparativa con PandoraFMS. Por ello, ya que explicamos un panorama general de Netcool ® (implementación, configuración, agentes y almacenamiento de información) sin incluir el software de predicción de problemas, comunicación entre responsables de soporte, etcétera; procedemos a razonar una visión general que incluso se puede extender a otros software de monitorización para así realizar comparativas9.
Por parte de las máquinas.
De manera masiva los agentes recogen todos los eventos e incidencias y sin excepción son almacenadas en poderosas bases de datos.
Por medio de reglas preestablecidas se procede a filtrar el material que cumpla con los requisitos, cada cliente tiene sus propias necesidades y/o prioridades, las que se necesitan se pasan al siguinte nivel.
Por parte de nosotros los humanos.
Las máquinas hicieron su trabajo, ahora toca a los humanos el evaluar alertas, identificar fallas y crear boletos para su resolución: estamos en la etapa de la detección. En este punto es bueno descartar los falsos positivos, no sin antes hacerle su debido registro, que puede ser utlizado a futuro para correlacionar eventos, lo que nos lleva al siguiente punto.
Los boletos que se abrieron en la etapa anterior se asignan de acuerdo a los conocimientos sobre el tema: estamos en la etapa de reacción.
Ya en manos adecuadas y familiarizadas con la falla o fallas en cuestión se procede a la revisión de pruebas y evidencias, estamos en la etapa de diagnóstico. Es acá donde se planifica el siguiente punto, del cual probablemente se encargará otro equipo de trabajo.
En la fase de restauración o reparación se aplican las medidas diseñadas dando así por finalizado el incidente a efectos de operatividad pero a nivel de predicción y evaluación a futuro se pasa a otros departamentos y esto excede ya las tareas de monitorización de servidores y redes y cae más bien en el campo de control y previsión de pérdidas.
El enfoque de PandoraFMS.
Es una lección aprendida que hay tareas adecuadas para las máquinas y tareas adecuada para los humanos10. Es por ello que en lo que se refiere a analizar millones de eventos y correlacionarlos pues las máquinas son las más adecuadas para recogerlas (primer paso que explicamos en el Modo de funcionamiento) y luego detectar las anomalías, incluso si están repetidas: esto es cuestión de segundos, lo que nos llevaría horas a nosotros el manejarlos. En lo que somos buenos los humanos es en analizar decenas de problemas y determinar sus causas de orígen, siempre teniendo a la mano los datos bien presentados para basar las decisiones. Minutos después se planificará la solución y será devuelta a las máquinas, quienes la aplicarán en segundos (y en unos cuantos segundos más aprenderán del fallo).
En este aspecto Pandora FMS rompe con lo establecido en monitorización11: evitamos la monitorización compleja y fragmentada fruto de múltiples productos con interfaces de usuario diferentes y separadas, funcionando sobre bases de código separadas y hasta almacenamientos aparte unas de otras; todo esto únicamente da como resultado una implementación sumamente complicada y peor aún, dificulta el mantenimiento una vez se haya logrado implementar. Se traduce que una gran complejidad tiene un coste muy elevado y un elevado tiempo de evaluación. Es por ello que a la hora de adaptarse a las necesidades del cliente PandoraFMS brilla por su estructura de un solo cuerpo, permite implementar los cambios sin retrasos en extensas reuniones de quipos de trabajo por departamento para evitar que los cambios en un módulo no perjudiquen y mantengan la compatibilidad con los otros componentes. Una vez modificado y actualizado el programa, PandoraFMS entrega a todos sus clientes una actualización inmediata gracias a nuestrao nuevo sistema de versionado, los parches y mejoras –incrementales– se irán aplicando de forma progresiva y secuencial desde la consola, sin necesidad de procesos de migración o actualización12. Una gran complejidad reduce la eficiencia.
Pros y contras de ambos productos.
Colocar en la balanza las ventajas y desventajas ayudará a discernir cual camino de monitorización será el mejor indicado para cada cliente.
Netcool ®
Pros
Tiene como ventaja una larga experiencia de procesos, los han visto todos y los tienen almacenados, categorizados y muy bien documentados. Será bastante difícil que una empresa cualquiera presente un reto nuevo a esta antiquísima y bien cultivada tecnología.
Contra
Precisamente el análisis al extremo de departamentalizar y establecer divisones especializadas conduce un trabajo adicional de comunicación y registro entre ellos, lo cual reduce la eficiencia. Se corre el riesgo, incluso, de aislamiento de áreas de monitorización. Otro punto es la subestimación de los requerimientos del cliente: se supone que ya está todo categorizado y normalizado y se trata de venderle del catálogo de productos los que se acerquen a la solución, aquí no hay productos a la medida.
PandoraFMS
Pro
Se maneja todo conjuntamente lo cual se traduce en rapidez, visión de un solo golpe de los eventos para su posterior solución y corrección. Acá se reduce grandemente el tiempo inactivo de la empresa, que es de gran coste económico. Dejamos que las máquinas hagan el trabajo que mejor saben hacer para que los humanos tengan la mínima intervención pero que a la hora de tomar las decisiones las hagan sobre datos sólidos, confiables y bien presentados. Teniendo mucho cuidado en no caer en gran complejidad, de hecho es opcional, se desarrolló Integria IMS13: una gestión correcta del flujo de trabajo de los equipos que responden a las incidencias presentadas.
Contra
Hay un refrán que dice «no hay mal que por bien no venga»: es como las administraciones de tráfico aéreo, cuando sucede una catástrofe no solamente se resuelve el caso sino que se aprovecha de implementar medidas a futuro para evitar su repetetición, incluso si suceden de manera análoga. Este punto se subsana porque en PandoraFMS la flexibilidad es nuestro compromiso y podremos escuchar para mejorar e incluso desarrollar elementos nuevos que suplan las carencias a futuro.
Marcas registradas.
IBM, the IBM logo, e ibm.com son marcas o marcas registradas de «International Business Machines Corporation», registrada en muchas jurisdicciones a nivel mundial. Otros productos y nombres de sevicios pueden pertenecer a IBM u otras compañías. Una lista actual de marcas registradas de IBM está disponible en internet en la página web titulada “Copyright and trademark information” ubicada en http://www.ibm.com/legal/copytrade.shtml
Los siguientes términos son marcas registradas de «International Business Machines Corporation», y también pueden ser marcas registras no solo en Estados Unidos sino en otros países:
DB2®
IBM®
JazzTM
Netcool ®
Passport Advantage®
Redbooks®
Redbooks (logo)
Tivoli®
WebSphere®
El logotipo aquí utilizado está definido por formas geométricas que no reúnen los requisitos para llegar al umbral de originalidad y por tanto reúne el requisito de dominio público: tales conceptos y ficheros pueden ser leídos en el siguiente enlace de Wikipedia: https://commons.wikimedia.org/wiki/File:IBM_logo.svg
Imágenes empleadas.
Aparte del logotipo de IBM® señalado debidamrente en la sección anterior, utilizamos las siguientes imágenes con sus orígenes:
«Creating custom standard drivers in IBM Tivoli Netcool Configuration Manager» en Wikimedia Commons.